Business · AI Products
AI 인프라 걱정없이
AI 혁신에만 집중하십시오
GPU·NPU 이기종 하드웨어부터 모델 서빙, 배포, 모니터링까지, AI 서비스 구동에 필요한 인프라 전 영역을 하나의 Control Plane에서 운영합니다. 쿠버네티스 기반 PaaS로 온프레미스와 멀티 클라우드를 모두 아우릅니다. 자원·서빙을 맡는 AURDA AI Infra와 접근·통제를 맡는 AURDA AI Gateway는 단독으로도, Suite로 결합해서도 도입할 수 있습니다.
Key Features
인프라 운영, 화면에서 끝냅니다
제품 화면 그대로 보여드립니다 - GPU 할당부터 배포·모니터링까지 콘솔 하나로 운영합니다.
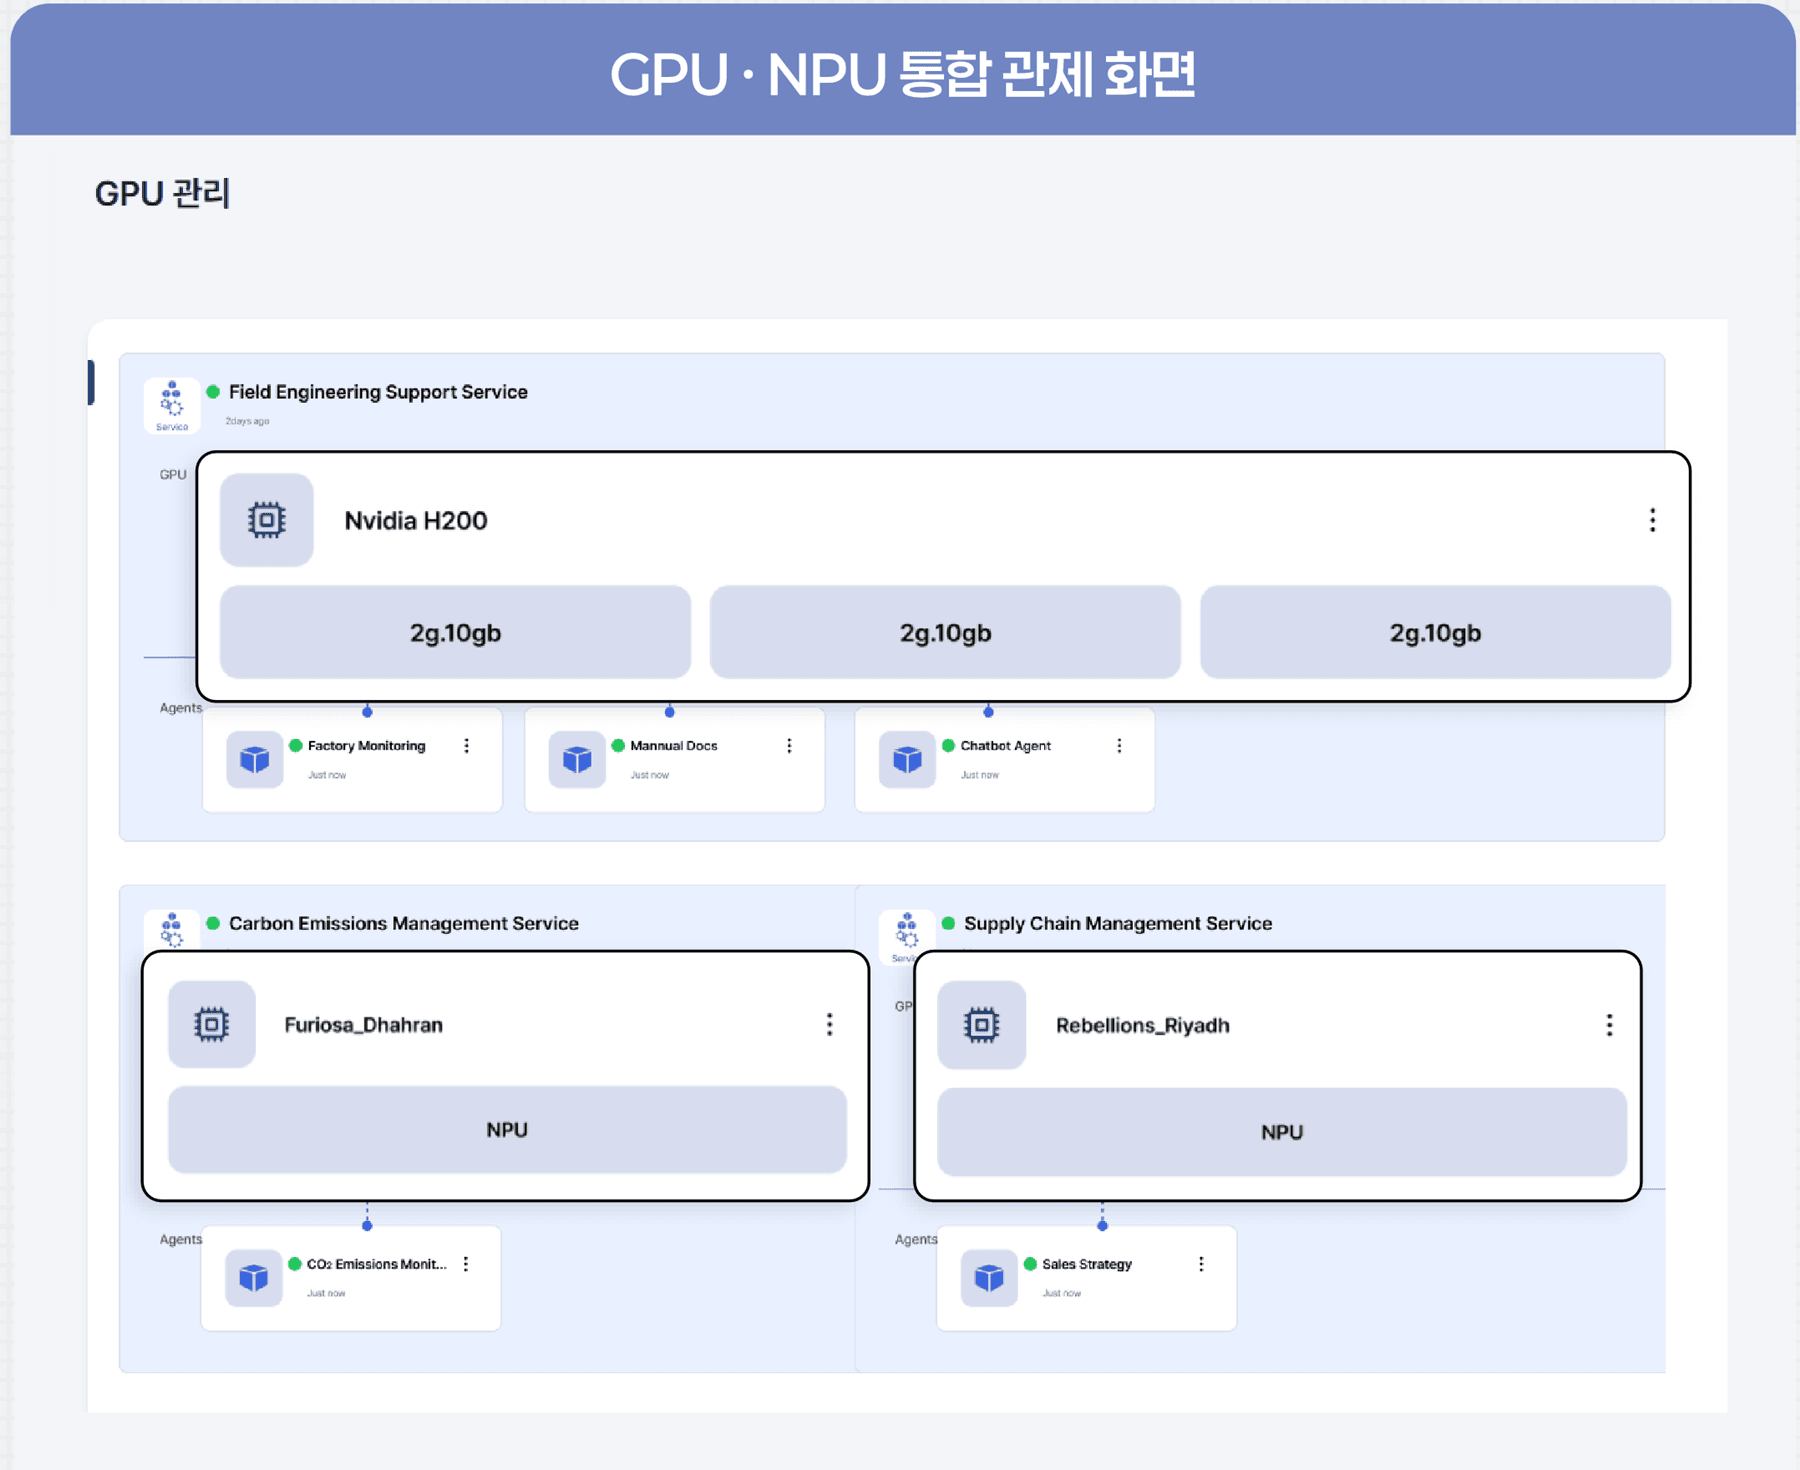
GPU·NPU Console
NVIDIA GPU와 국산 NPU를 한 화면에서
NVIDIA H200부터 퓨리오사·리벨리온 NPU까지 단일 콘솔에서 혼합 운용합니다. 벤더 종속 없이 워크로드별 최적 하드웨어를 선택하고, 노드 추가 시 자동 인식되어 무중단으로 편입됩니다.
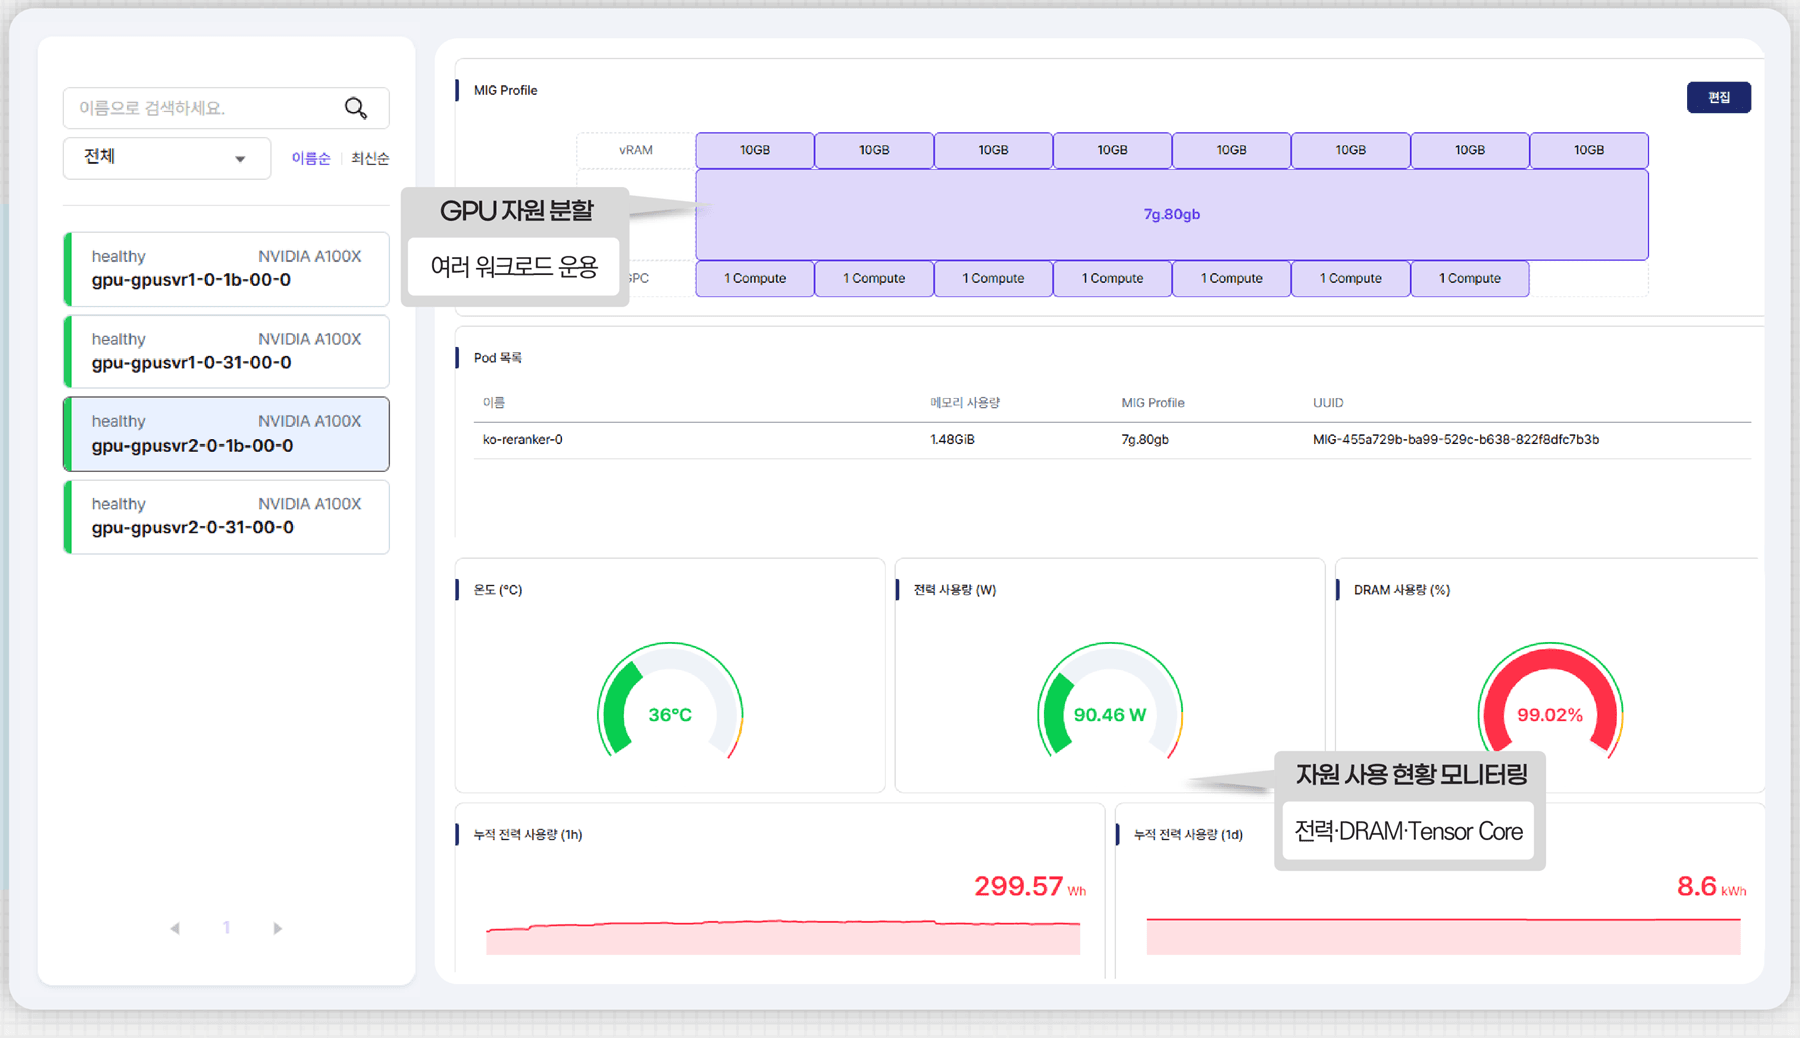
MIG Partitioning
하나의 GPU를 여러 워크로드로, 정밀 분할
MIG 기술로 고성능 GPU를 최대 7개 독립 인스턴스로 분할해 연산·메모리를 물리 격리합니다. 온도·전력·DRAM 사용률까지 GPU 상태를 실시간으로 추적합니다.
Model Serving
클릭 한 번으로 LLM 배포
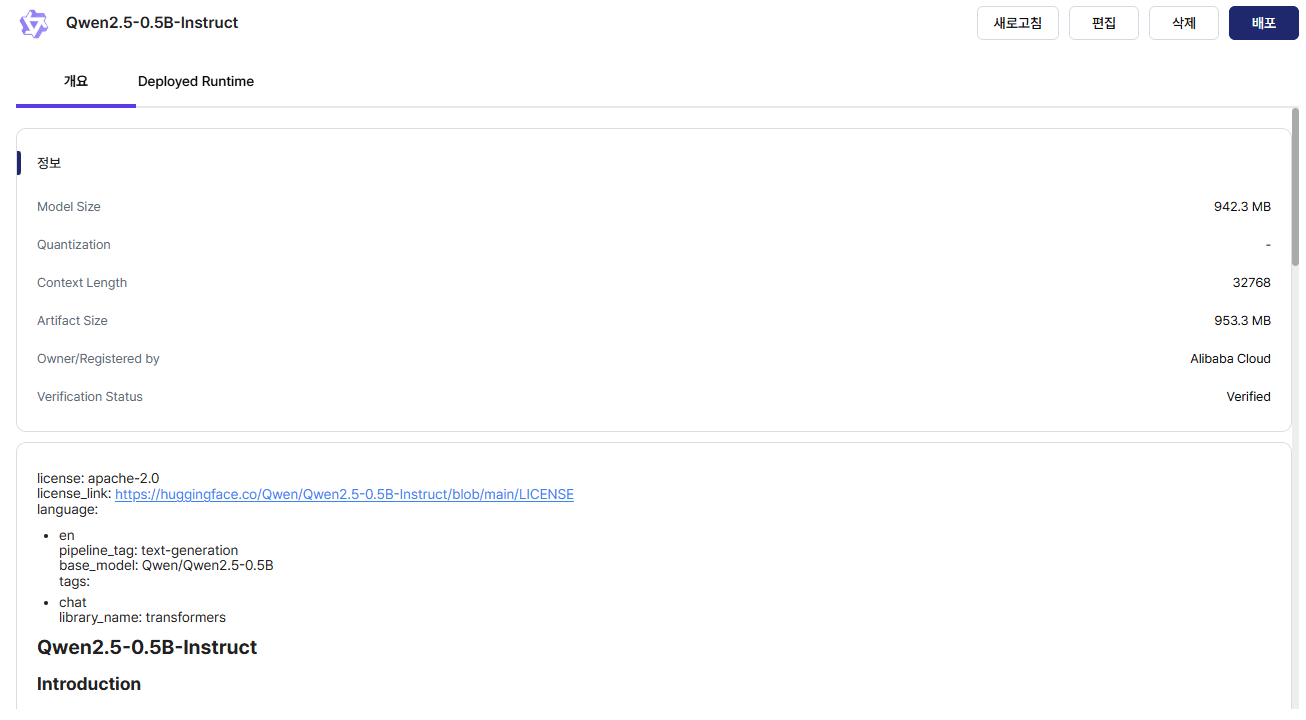
모델·GPU 자원·런타임을 선택하면 콘솔에서 즉시 배포됩니다. vLLM 고성능 추론 엔진을 지원하고, 폐쇄망에서는 내부 저장소에서 직접 모델을 로딩해 외부 인터넷 없이 서비스를 구동합니다.
GitOps
인프라와 배포를 코드로, 언제든 롤백
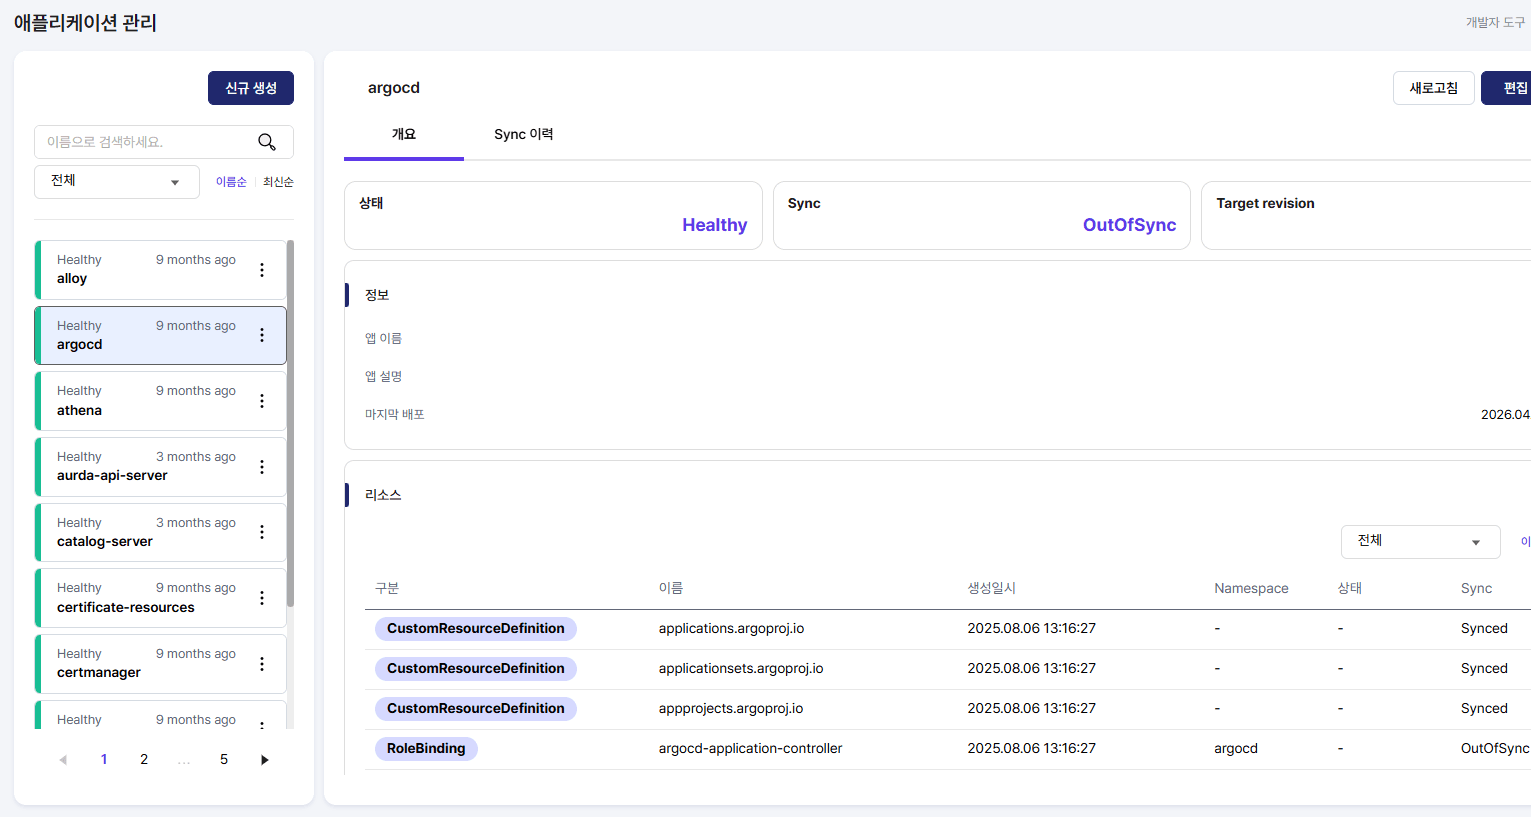
ArgoCD 기반으로 Git에 정의된 상태를 클러스터에 자동 반영합니다. Git 정의와 실제 상태의 차이(Drift)를 즉시 감지하고, 장애 발생 시 이전 버전으로 즉시 복구합니다.
Autoscale
부하에 맞춰 서빙 인스턴스를 자동 확장
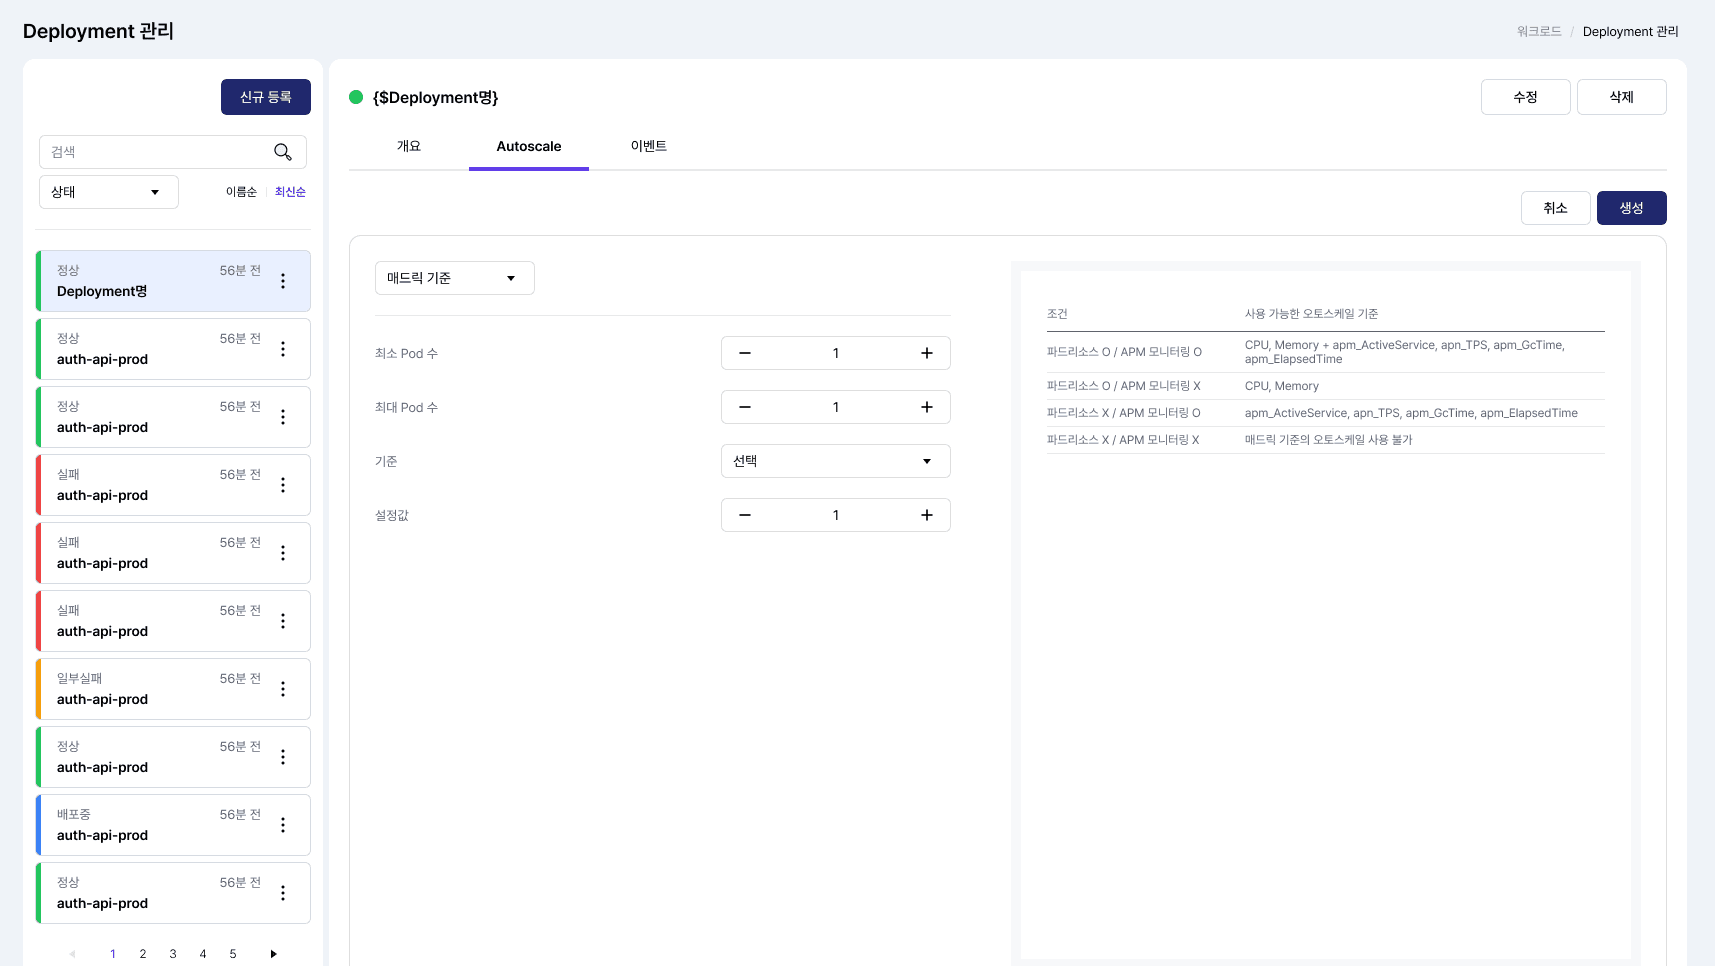
메트릭 기준으로 확장 조건을 정하면 부하 급증 시 서빙 인스턴스를 자동으로 늘리고 가용 인스턴스로 분산합니다. 사내 모델과 외부 LLM을 하나의 API로 묶어 트래픽을 배분하는 일은 AURDA AI Gateway가 맡습니다.
Observability
인프라부터 LLM 추론까지, 대시보드 하나로
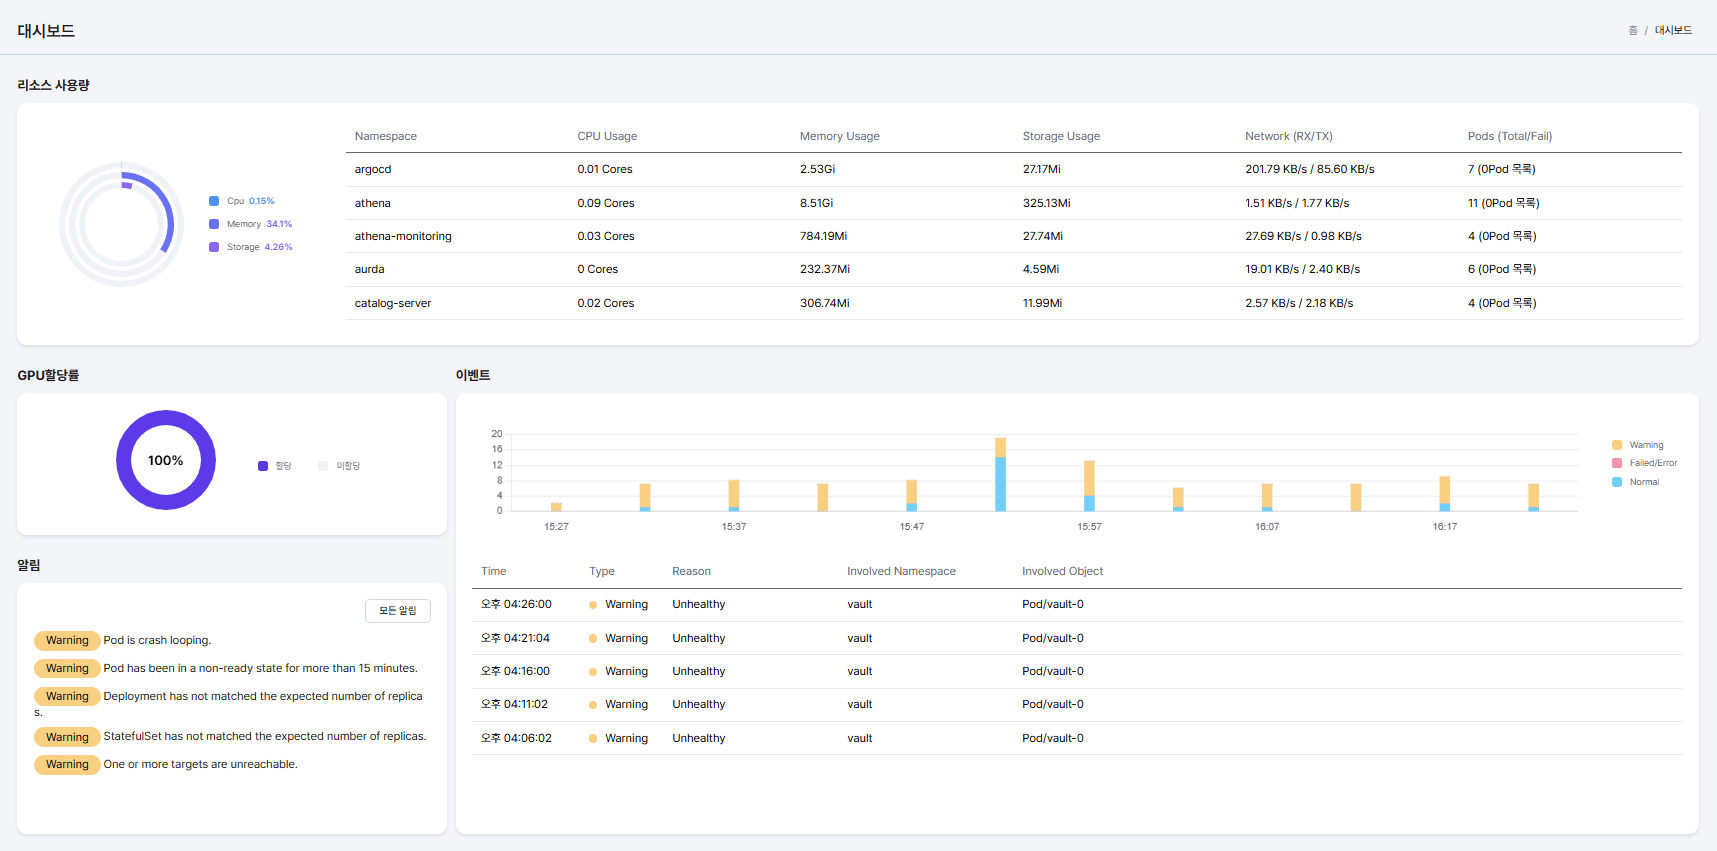
GPU 사용률·온도·전력부터 LLM 성능 지표(TTFT·TPS)까지 단일 대시보드에서 추적합니다. Loki 기반 중앙 로그와 임계치 기반 실시간 알림으로 장애 대응 시간을 단축합니다.
Platform
AI 인프라 운영의 표준을 정의하다
컨테이너 가상화부터 보안까지 - 쿠버네티스 오케스트레이션 위에 AI 운영에 필요한 전부를 얹었습니다.
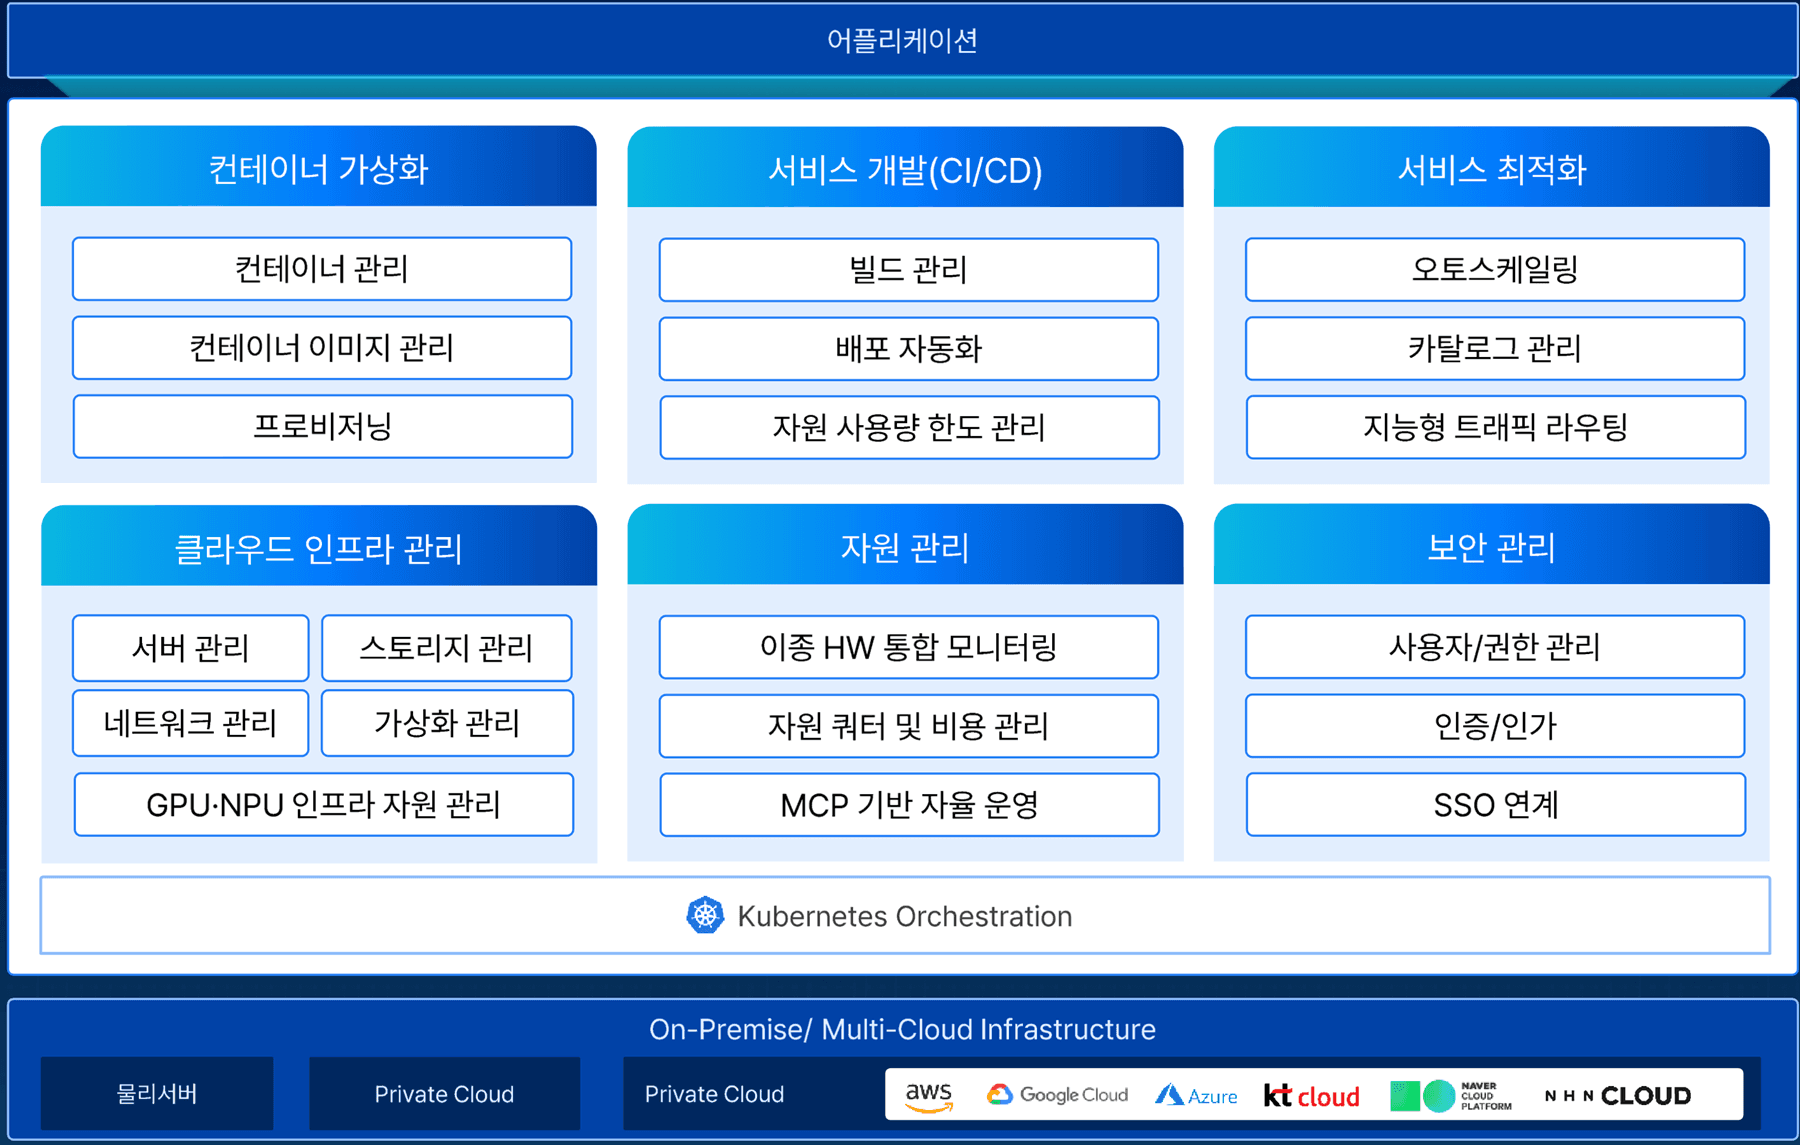
Architecture
6개 관리 영역, 하나의 플랫폼
컨테이너 가상화·서비스 개발(CI/CD)·서비스 최적화·클라우드 인프라·자원·보안 관리까지 - 온프레미스와 멀티 클라우드를 아우르는 쿠버네티스 기반 통합 구조입니다.
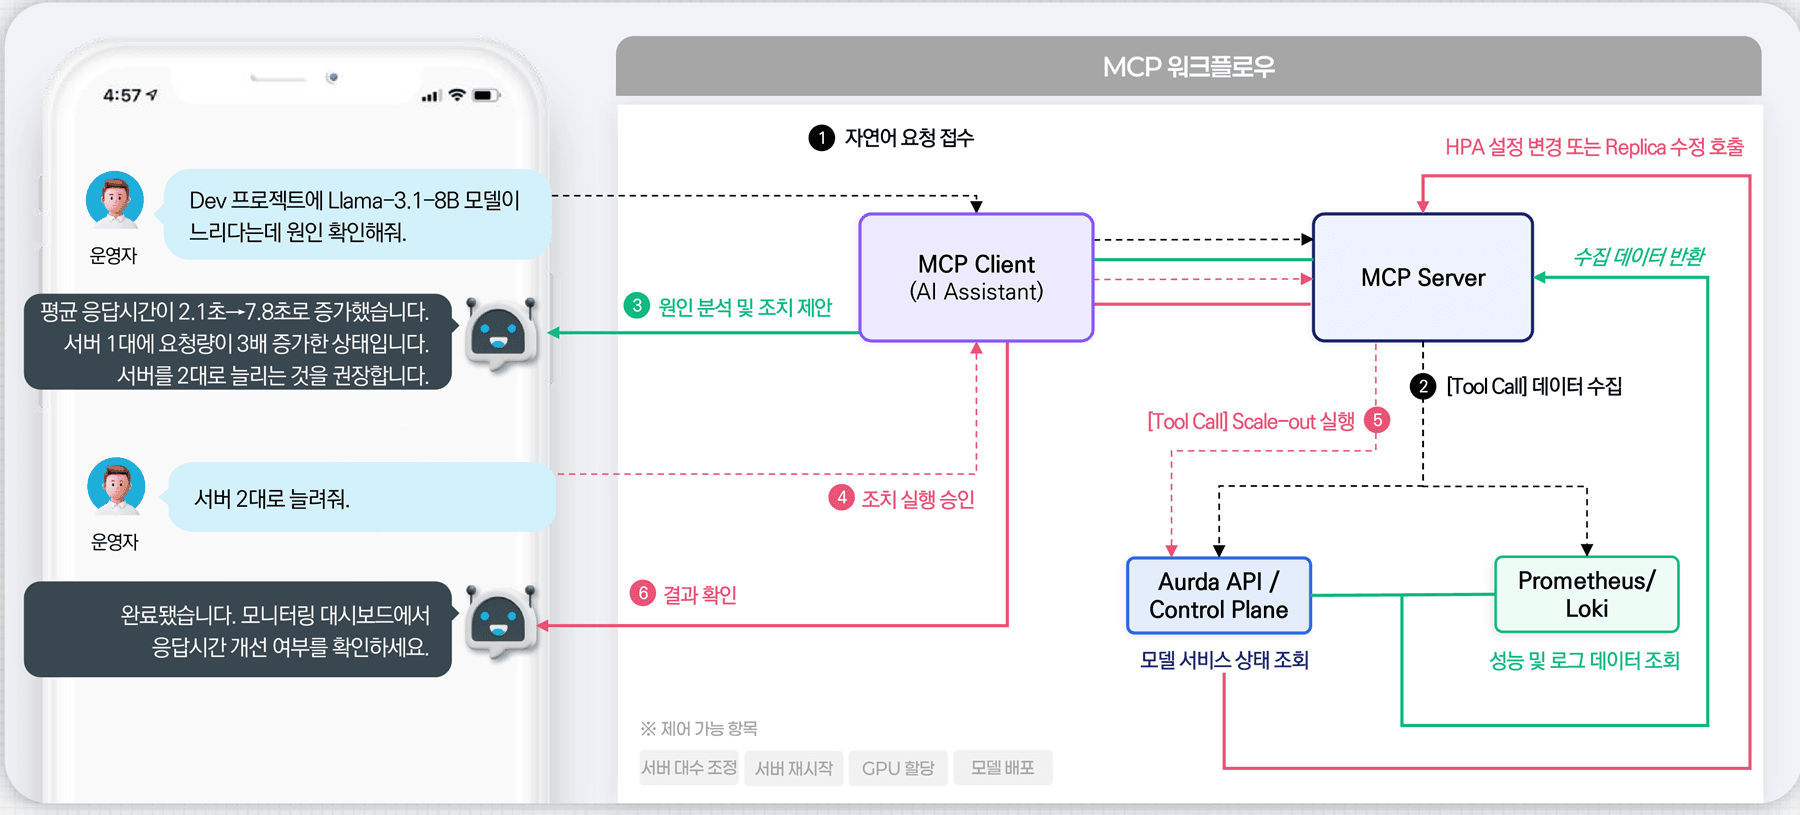
Agentic ChatOps
"서버 2대로 늘려줘" - 말로 하는 인프라 운영
MCP 기반 AI 에이전트가 자연어 명령을 해석해 원인 분석부터 스케일아웃까지 수행합니다. 장애 대응 시간을 단축하고 반복 운영 업무를 대화로 끝냅니다.
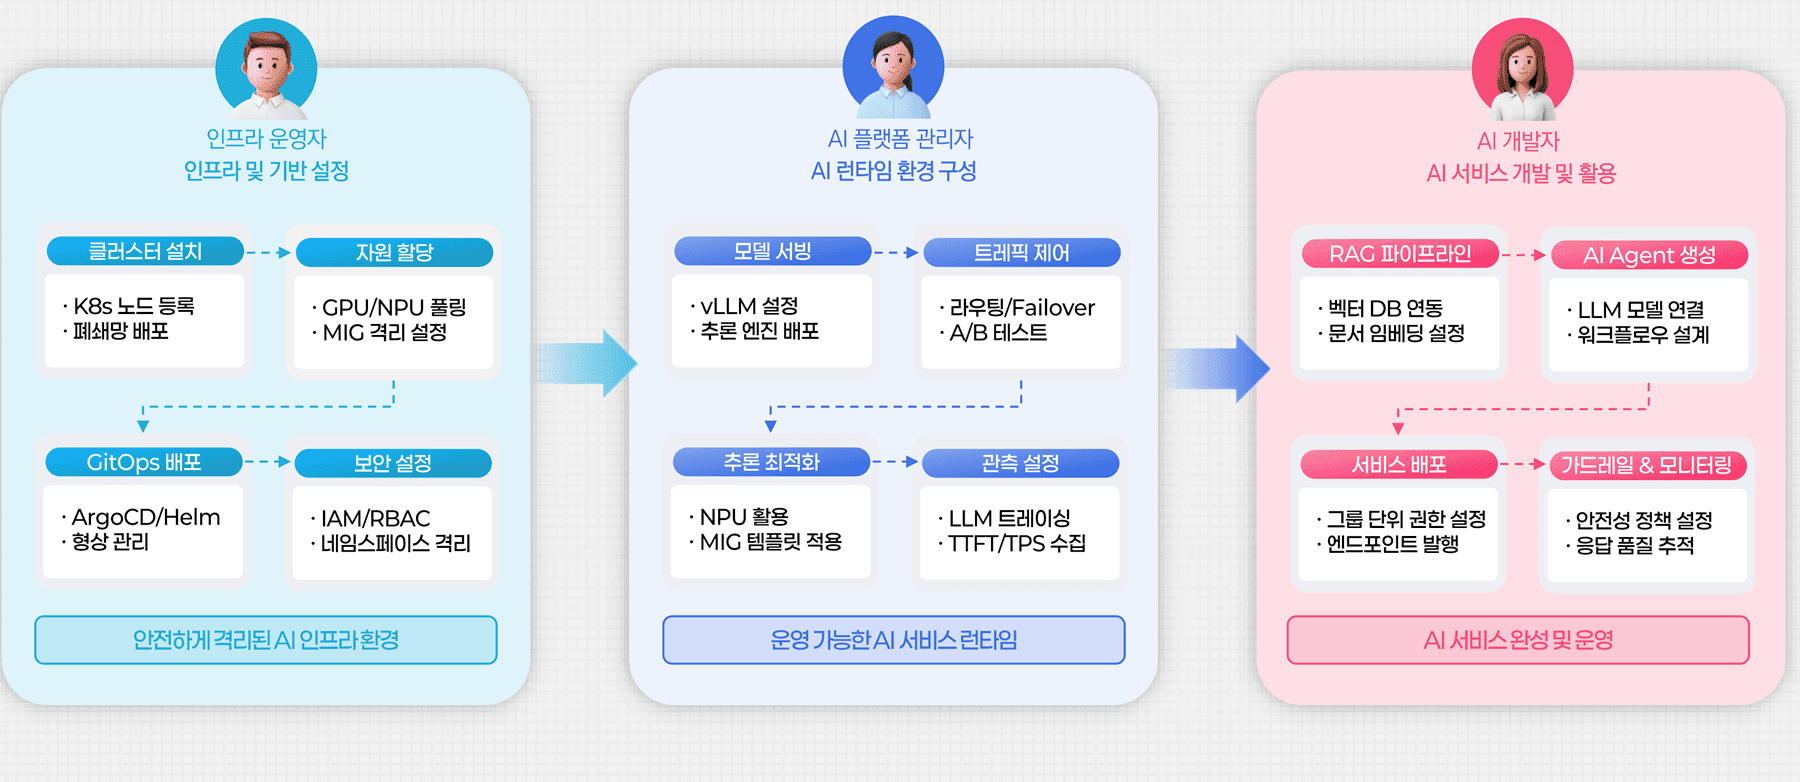
Role-based Workflow
운영자·관리자·개발자, 역할대로 흐릅니다
인프라 운영자의 클러스터 설치·보안 설정부터 플랫폼 관리자의 모델 서빙·추론 최적화, AI 개발자의 RAG·Agent 개발까지 - 역할별 운영 흐름이 플랫폼 안에 설계돼 있습니다.
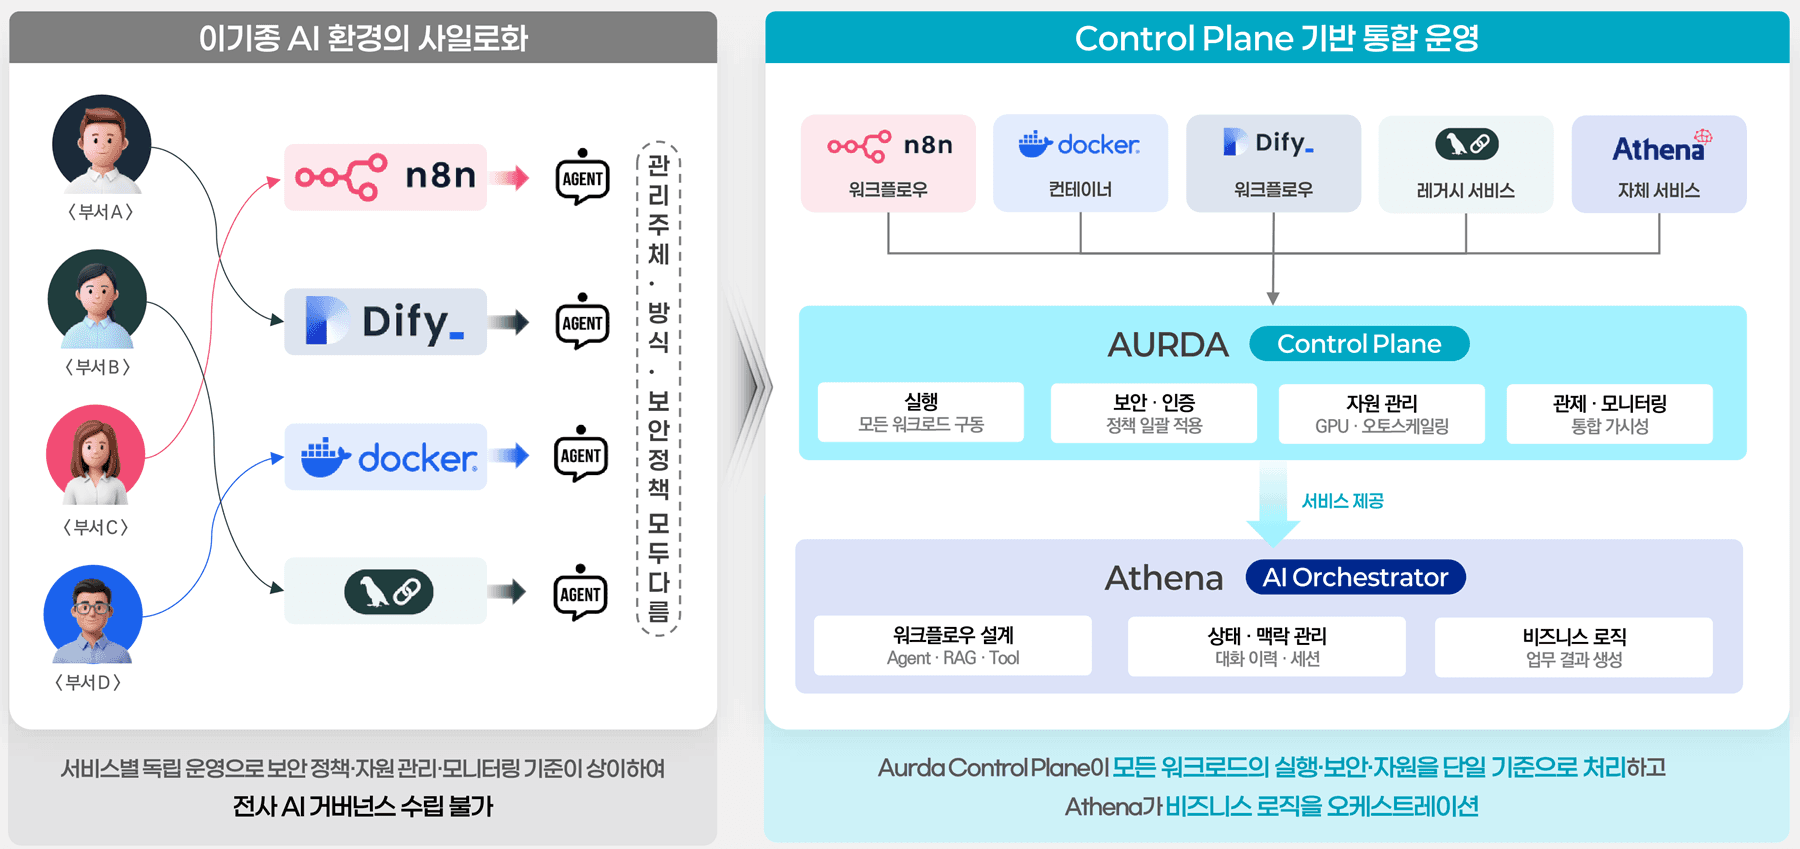
Universal AI Runtime
n8n·Dify·Docker까지, 이기종 워크로드 통합
부서마다 흩어진 워크플로우·컨테이너·레거시 Agent를 AURDA Control Plane이 단일 기준으로 실행·보안·관제합니다. 전사 AI 거버넌스가 비로소 가능해집니다.
Architecture
Enterprise AI OS의 자원 계층
AI Portal·AI Studio·AI Gateway 아래에서 AURDA AI Infra가 가속기와 서빙을 맡습니다.
Enterprise AI OS
사용·개발·통제·자원, 네 계층의 맨 아래
AI Portal(사용·승인), AI Studio·Athena(Agent 생명주기), AURDA AI Gateway(실행·거버넌스)가 위에서 돌고, AURDA AI Infra는 물리 서버·클라우드·NVIDIA GPU·국산 NPU 위에서 자원과 서빙을 맡습니다.
Disaggregated Inference
문서 읽기와 답변 생성, 자원을 따로 씁니다
입력 처리(Prefill)는 연산이 많고 답변 생성(Decode)은 메모리를 많이 씁니다. 두 단계를 서로 다른 가속기 풀에 분리해 할당하고 단계별로 따로 확장하면 GPU 활용률은 올라가고 전력은 내려갑니다.
Why AURDA AI Infra
벤더 종속 없이, 자원 효율로 승부합니다
GPU·국산 NPU 이기종 자원과 모델·Agent 서빙을 통합 관리해 AI 인프라 비용과 운영 부담을 줄입니다.
| 기능 | 글로벌 상용 솔루션 | 오픈소스 자체 구축 | AURDA AI Infra |
|---|---|---|---|
| 이종 하드웨어 | NVIDIA GPU 생태계 중심 | 장비별 개별 구성 필요 | GPU·국산 NPU 통합 관제, 벤더 비종속 |
| 자원 분할·효율 | 스케줄링 중심, 세부 분할은 별도 구성 | 기본 스케줄링 수준 | MIG 동적 분할·쿼터 관리로 활용률 제고 |
| 적용 범위 | 워크로드 스케줄링 중심 | 개별 도구를 조합해 구성 | 모델 서빙부터 Agent 서빙까지 통합 |
| 운영 방식 | 콘솔, 전문 인력 중심 운영 | 전문 인력 의존도 높음 | Agentic ChatOps 자연어 제어로 운영 부담 완화 |
2026년 10월, 당사 제품 기준 정성 비교분리 추론 서빙: 입력(Prefill)·생성(Decode) 단계별로 추론 자원을 분리해 할당·확장합니다.
Customer Story
현장에서 검증된 AURDA
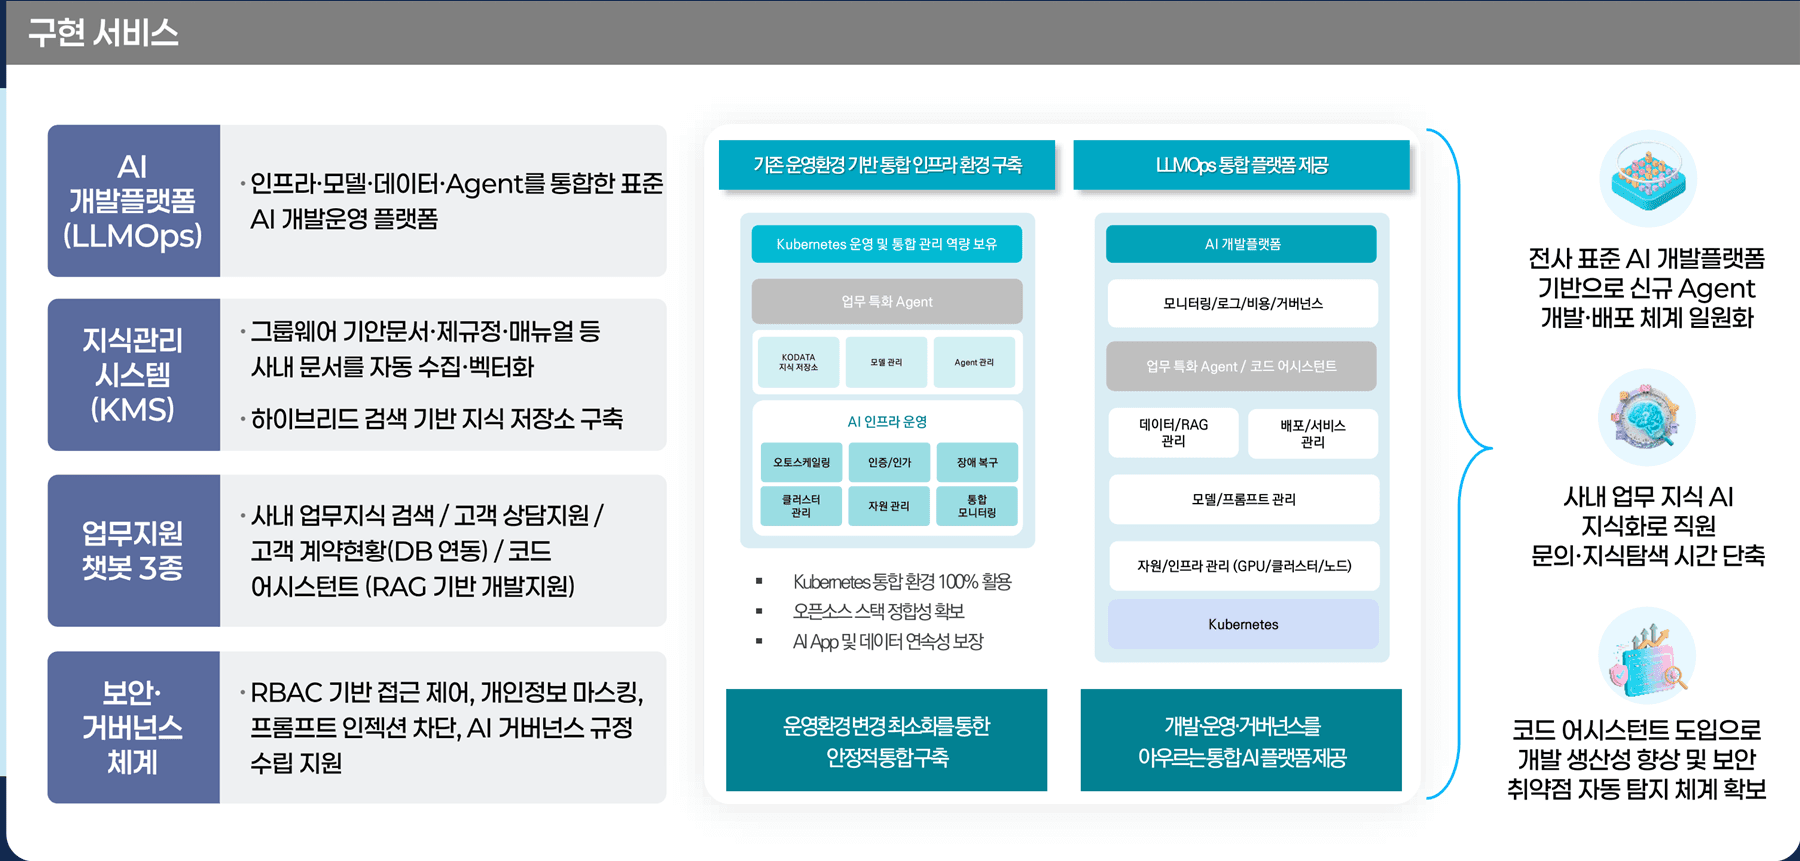
한국평가데이터
전사 표준 AI 개발플랫폼 구축 (LLMOps + KMS)
H200 기반 Kubernetes 환경 위에 인프라·모델·데이터·Agent를 통합한 표준 AI 개발운영 플랫폼을 구축해, 과제별로 흩어져 있던 13개 AI Agent의 개발·배포 체계를 일원화합니다.
AURDA Suite
자원부터 사용 통제까지 한 체계로
AI Infra + AI Gateway
자원·서빙은 AI Infra가, 접근·통제는 AI Gateway가
AURDA AI Infra가 GPU·NPU 자원과 모델·Agent 서빙을, AURDA AI Gateway가 접근·통제·연계를 맡습니다. MCP 서버의 등록·배포·버전 관리와 접근 권한·호출 통제는 AI Gateway가 맡습니다. 단독으로도, 결합해서도 도입하며, AI Gateway는 타사 GPU 환경에도 단독 도입할 수 있습니다.
제공되는 파일은 제품소개서(PDF)입니다. 프로그램 설치 파일은 제공하지 않습니다.제품을 직접 살펴보고 싶으시면 도입 문의로 요청해 주세요.
Download